Чек-лист
кодовое словоВопросы

Собеседование AI-инженера: 5 тем про продакшен

27 вопросов с собеседований AI-инженеров по пяти темам - агенты, RAG, идемпотентность, оценка и масштаб, - и что должно прозвучать в сильном ответе. Пройди каждую тему, ответь вслух на каждый вопрос и отметь, где плаваешь.

Содержание6 глав
  1. 01Агенты и обвязка
  2. 02RAG и поиск
  3. 03Надёжность и идемпотентность
  4. 04Оценка
  5. 05Масштаб LLM-приложений
  6. 06Проверь себя

Про обучение моделей тут почти не спрашивают. Весь разговор сводится к одному: сможешь ли ты довести AI-прототип до продакшена. Ниже пять тем, по каждой - что спрашивают и опорные пункты ответа.

Как готовиться
Отвечай вслух и на примере своего проекта. Определение из учебника - слабый ответ. Сильный - «вот что сломалось, вот как я это поймал, вот что поменял».

Тема 1

Агенты и обвязка

Модель - только центр. Вокруг неё состояние, инструменты, права доступа, повторы и логи. Проверяют, понимаешь ли ты, что из этого и зачем строить.

01
Чем агент отличается от workflow и когда агент не нужен?
Workflow - заранее заданный путь, агент сам выбирает следующий шаг. Скажи, что начинаешь с самого простого решения и добавляешь автономию, только когда она окупает цену, задержку и риск ошибок
02
Где агент хранит состояние между шагами и что будет, если процесс упадёт посередине?
Состояние - вне памяти процесса: история шагов, результаты инструментов, текущая цель. После падения агент продолжает с последнего сохранённого шага, а не начинает заново
03
Как ты описываешь инструменты, чтобы модель вызывала их правильно?
Понятное имя, описание с примерами, строгая схема аргументов, внятные ошибки. Плохое описание инструмента ломает агента чаще, чем слабая модель
04
Как ограничить права агента?
Минимум прав на каждый инструмент, разделение чтения и записи, подтверждение человеком для необратимых действий - оплата, удаление, отправка наружу
05
Что делаешь, если инструмент ответил ошибкой или агент зациклился?
Повтор с паузой для временных ошибок, лимит шагов и бюджета токенов на задачу, остановка с понятной причиной вместо бесконечного цикла
06
Что логируешь, чтобы разобрать плохой ответ агента?
Трассу целиком: промт, каждый вызов инструмента с аргументами и ответом, токены, задержку, итог. Без трассы разбор - гадание

Building effective agents - Anthropic

Тема 2

RAG и поиск

«Что такое RAG» уже не спрашивают. Спрашивают, точно ли найденный кусок документа относится к вопросу: чанки, эмбеддинги, top-k и реранк.

01
Как ты режешь документы на чанки и как выбираешь размер?
По смыслу - разделы, абзацы, - а не по фиксированному числу символов, с небольшим перекрытием. Размер подбираешь на своих вопросах: слишком мелкий теряет контекст, слишком крупный размывает поиск
02
Почему поиск только по эмбеддингам промахивается?
Эмбеддинги ловят смысл, но теряют точные совпадения - артикулы, коды ошибок, имена. Поэтому гибрид: векторный поиск плюс BM25 по ключевым словам
03
Как выбираешь top-k и зачем нужен реранк?
Сначала достаёшь с запасом - например, 20-50 кандидатов, - потом реранкер пересортировывает их по реальной связи с вопросом, и в модель идут лучшие несколько
04
Как проверить, что найденный контекст относится к вопросу?
Отдельно мерить поиск и ответ. Для поиска - набор «вопрос → правильный чанк» и метрика, нашёлся ли он в top-k. Для ответа - опирается ли он только на найденное
05
Чанк вырван из документа и потерял смысл. Что делаешь?
Добавляешь к чанку контекст: заголовок документа и раздела или короткое пояснение, о чём этот кусок.
06
Что делает модель, если нужного в базе нет?
Говорит, что не нашла, а не придумывает. Это задаётся в промте и проверяется отдельными тестами на запросы, ответа на которые в базе нет

Contextual Retrieval - Anthropic

Тема 3

Надёжность и идемпотентность

Повтор запроса - это ещё не надёжность. Сервис упал, запрос ушёл второй раз, и без ключа идемпотентности клиент заплатил дважды.

01
Что такое идемпотентная операция?
Её можно выполнить несколько раз с тем же результатом, что и один раз. GET и DELETE идемпотентны по определению, создание платежа через POST - нет
02
Почему ретраи без ключа опасны?
Клиент не знает, дошёл ли запрос: ответ мог потеряться уже после списания. Повтор без ключа - второе списание
03
Как работает ключ идемпотентности?
Клиент генерирует уникальный ключ - например, UUID v4 - и шлёт его с запросом.
04
Что если пришёл тот же ключ, но с другими параметрами?
Ошибка, а не выполнение. Сервер сравнивает параметры с исходным запросом - так ловится случайное переиспользование ключа
05
Как это связано с LLM-приложением?
Агент и воркеры тоже ретраят: повтор шага может второй раз отправить письмо, создать заказ или списать деньги.
curl https://api.stripe.com/v1/customers \
  -u sk_test_...: \
  -H "Idempotency-Key: KG5LxwFBepaKHyUD" \
  -d description="My First Test Customer"

Так выглядит ключ в запросе к Stripe

Idempotent requests - Stripe

Тема 4

Оценка

Тестовый набор обычно лёгкий, а в проде прилетают сложные случаи - и метрики с тестов там не держатся.

01
Почему метрики на тестах не совпадают с продом?
Тестовый набор собирали руками, и в нём простые, чистые запросы. В проде - опечатки, длинный контекст, запросы не по теме и редкие случаи, которых в тестах нет
02
Как собрать набор сложных случаев?
Брать из реальных логов: жалобы, дизлайки, ответы, которые исправил человек, запросы, на которых упал агент. Каждый разобранный провал становится новым тестом
03
Чем мерить качество, если правильный ответ не один?
Где можно - простые проверки кодом: формат, наличие нужных полей, запрещённые слова. Где нельзя - LLM-судья с чёткими критериями, и его оценки сверяешь с оценками человека
04
Как понять, что новая версия промта не сломала старое?
Прогнать весь набор до и после и сравнить по каждому случаю, а не по средней цифре. Средняя может вырасти, пока важный сценарий сломался
05
Как следишь за качеством уже в проде?
Логи и трассы, выборочная ручная проверка, сигналы пользователей, алерты на рост отказов и пустых ответов

Your AI Product Needs Evals - Hamel Husain

Тема 5

Масштаб LLM-приложений

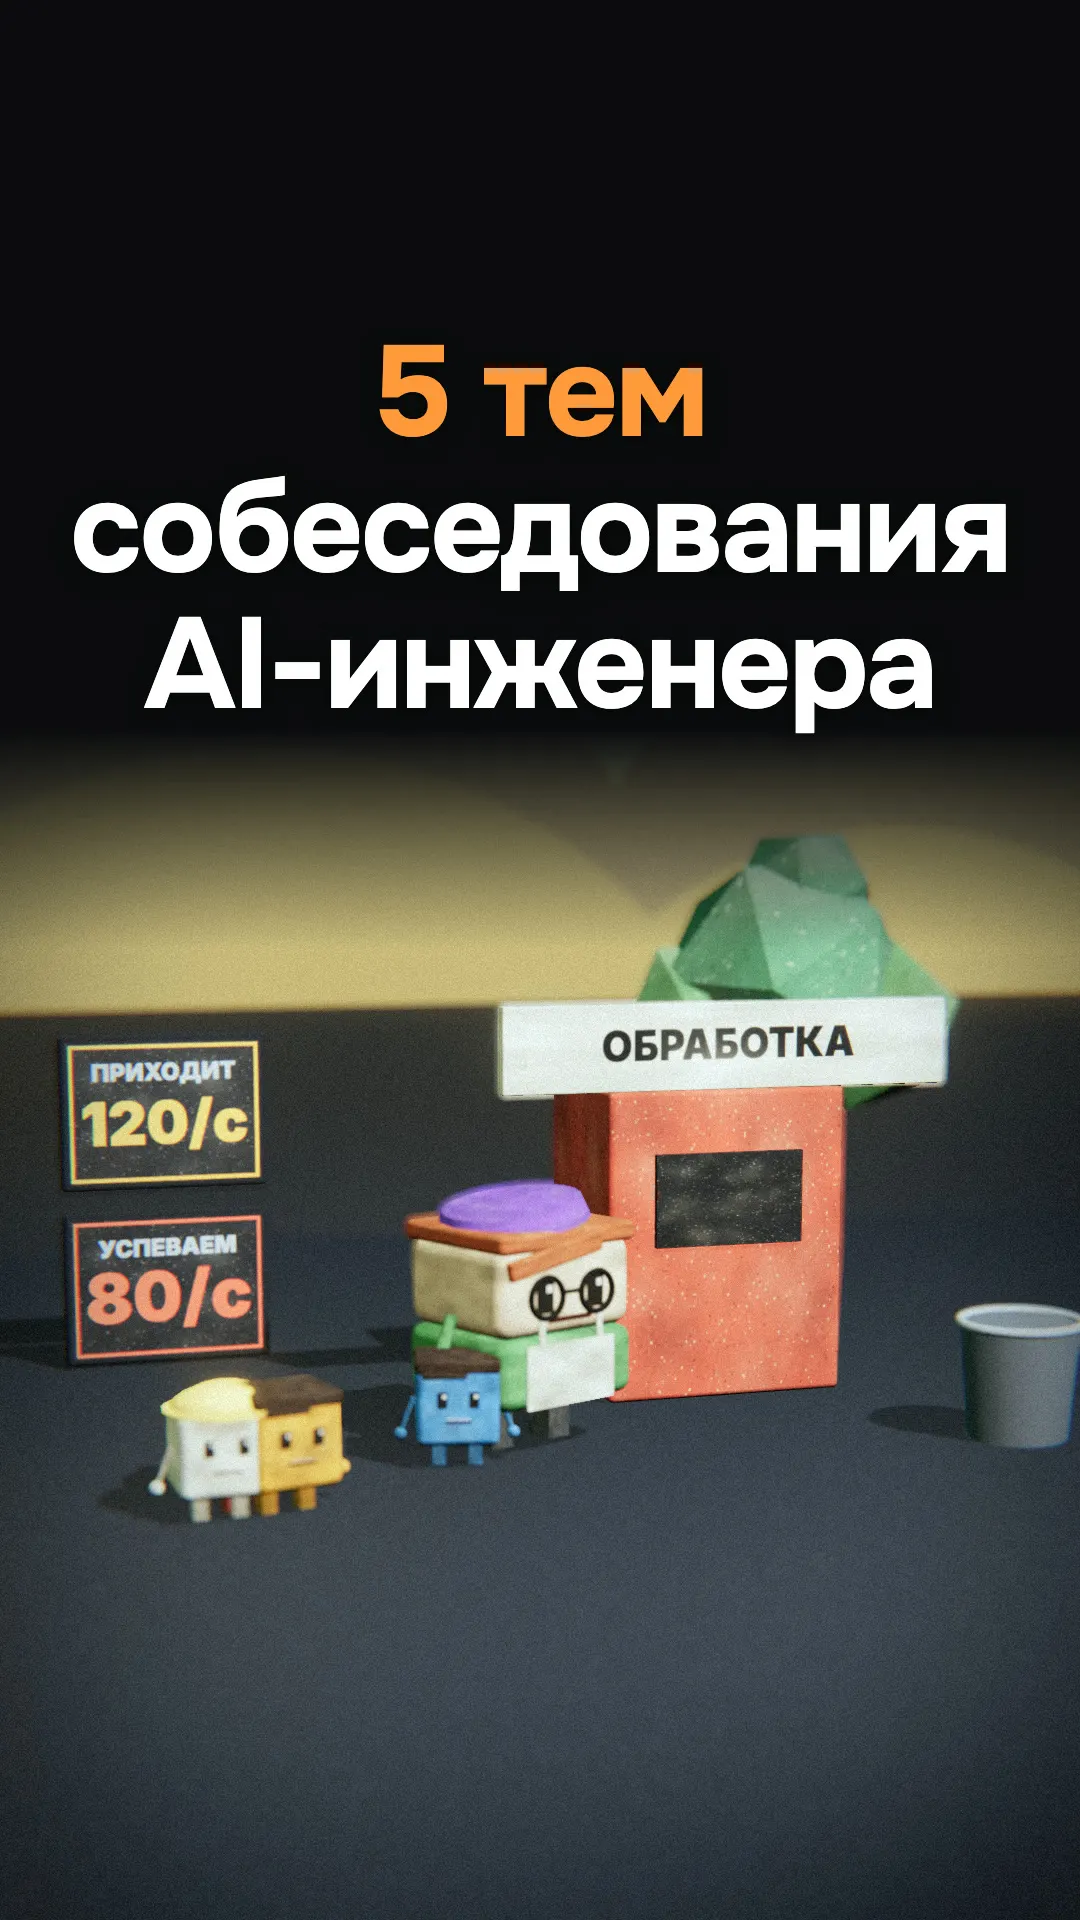
Приходит 120 запросов в секунду, воркеры тянут 80. Очередь мощности не добавляет, она просто копит хвост. Плюс лимиты RPM и TPM, цена и задержка.

01
Приходит 120 запросов в секунду, обрабатываешь 80. Что будет?
+40 запросов/с в хвост
Хвост растёт на 40 запросов в секунду - 2 400 в минуту, - и задержка растёт вместе с ним.
02
Что такое RPM и TPM и что делать при 429?
Лимиты провайдера: запросы в минуту и токены в минуту. При ошибке 429 ждать столько, сколько сказано в заголовке retry-after, и повторять с растущей паузой, а не долбить API сразу
03
Как снизить нагрузку на лимиты и цену?
Кэшировать повторяющуюся часть промта, отдавать простые задачи модели поменьше, резать лишний контекст, неспешные задачи гнать пакетом
04
Как уменьшить задержку для пользователя?
Стримить ответ, параллелить независимые вызовы, держать короткий промт, ставить таймауты и запасного провайдера или модель
05
Как защитить систему, когда очередь растёт?
Ограничить длину очереди, отдавать понятный отказ вместо бесконечного ожидания, разделить приоритеты - платные и интерактивные запросы вперёд фоновых
Промт 12 строки · 113 знаков
рост хвоста = входящие - обработанные = 120 - 80 = 40 запросов/с
через минуту в очереди: 40 × 60 = 2 400 запросов

Посчитай хвост очереди сам

Rate limits - Claude API


Итог

Проверь себя

  • Объясни вслух, когда нужен агент, а когда хватит workflow
  • Расскажи, где агент хранит состояние и что логируешь в трассе
  • Нарисуй RAG-конвейер: чанки, эмбеддинги + BM25, top-k, реранк
  • Назови, как отдельно мерить качество поиска и качество ответа
  • Объясни на примере платежа, зачем нужен ключ идемпотентности
  • Скажи, что сервер делает с повтором того же ключа и с тем же ключом, но другими параметрами
  • Собери из своих логов 10 сложных случаев для тестового набора
  • Опиши, как сравниваешь две версии промта по каждому случаю
  • Посчитай хвост очереди при 120 входящих и 80 обработанных в секунду
  • Перечисли три способа уложиться в лимиты RPM и TPM
  • Ответь на каждый вопрос из пяти тем на примере своего проекта